Python 量化统计基础
统计是量化策略的内功:收益率的分布形态决定风险模型怎么建,平稳性决定哪些方法可用,协整决定配对交易能不能做。
本篇用真实数据回答三个问题:收益率服从正态分布吗?价格序列平稳吗?什么样的两只股票才能做配对?
收益率服从正态分布吗
很多经典模型(如马科维茨组合理论)建立在"收益率服从正态分布"的假设上,这个假设值得先检验。
用茅台 2019-2024 的日收益率计算三大特征值:
实例
from scipy import stats
close = yf.download("600519.SS", start="2019-01-01", end="2024-12-31",
progress=False, multi_level_index=False)["Close"]
ret = close.pct_change().dropna()
print(f"样本数 {len(ret)} | 均值 {ret.mean():.4%} | 标准差 {ret.std():.4%}")
print(f"偏度 {ret.skew():.4f} | 峰度 {ret.kurtosis():.4f}(正态分布两者均为 0)")
# Jarque-Bera 正态性检验
jb, pvalue = stats.jarque_bera(ret)
print(f"Jarque-Bera 统计量 {jb:.1f},p 值 {pvalue:.2e}")
输出结果如下所示:
样本数 1452 | 均值 0.0901% | 标准差 1.8671%
偏度 0.3425 | 峰度 2.7022(正态分布两者均为 0)
Jarque-Bera 统计量 465.7,p 值 7.41e-102
三个证据都指向同一个结论:
| 指标 | 实际值 | 正态分布要求 | 解读 |
|---|---|---|---|
| 偏度 | 0.3425 | 0 | 分布轻微右偏 |
| 峰度 | 2.7022 | 0 | 显著的"尖峰肥尾" |
| Jarque-Bera p 值 | 7.41e-102 | 大于 0.05 | 强烈拒绝正态假设 |
"尖峰肥尾"的直观含义:大部分日子波动不大(尖峰),但极端日子的出现频率远高于正态假设(肥尾)。
把收益率直方图与同均值同标准差的正态曲线叠加,肥尾清晰可见:
实例
import numpy as np
from scipy import stats
plt.figure(figsize=(12, 6))
plt.hist(ret, bins=80, density=True, alpha=0.55,
color="#14805e", label="Daily Returns")
# 同均值、同标准差的正态密度曲线
xs = np.linspace(ret.min(), ret.max(), 400)
plt.plot(xs, stats.norm.pdf(xs, ret.mean(), ret.std()),
color="#1f2933", linewidth=1.8, linestyle="--",
label="Normal Distribution")
plt.title("Maotai Daily Returns vs Normal Distribution (2019-2024)")
plt.xlabel("Daily Return")
plt.ylabel("Density")
plt.legend()
plt.grid(alpha=0.25)
plt.show()
执行以上代码,输出的图表如下:
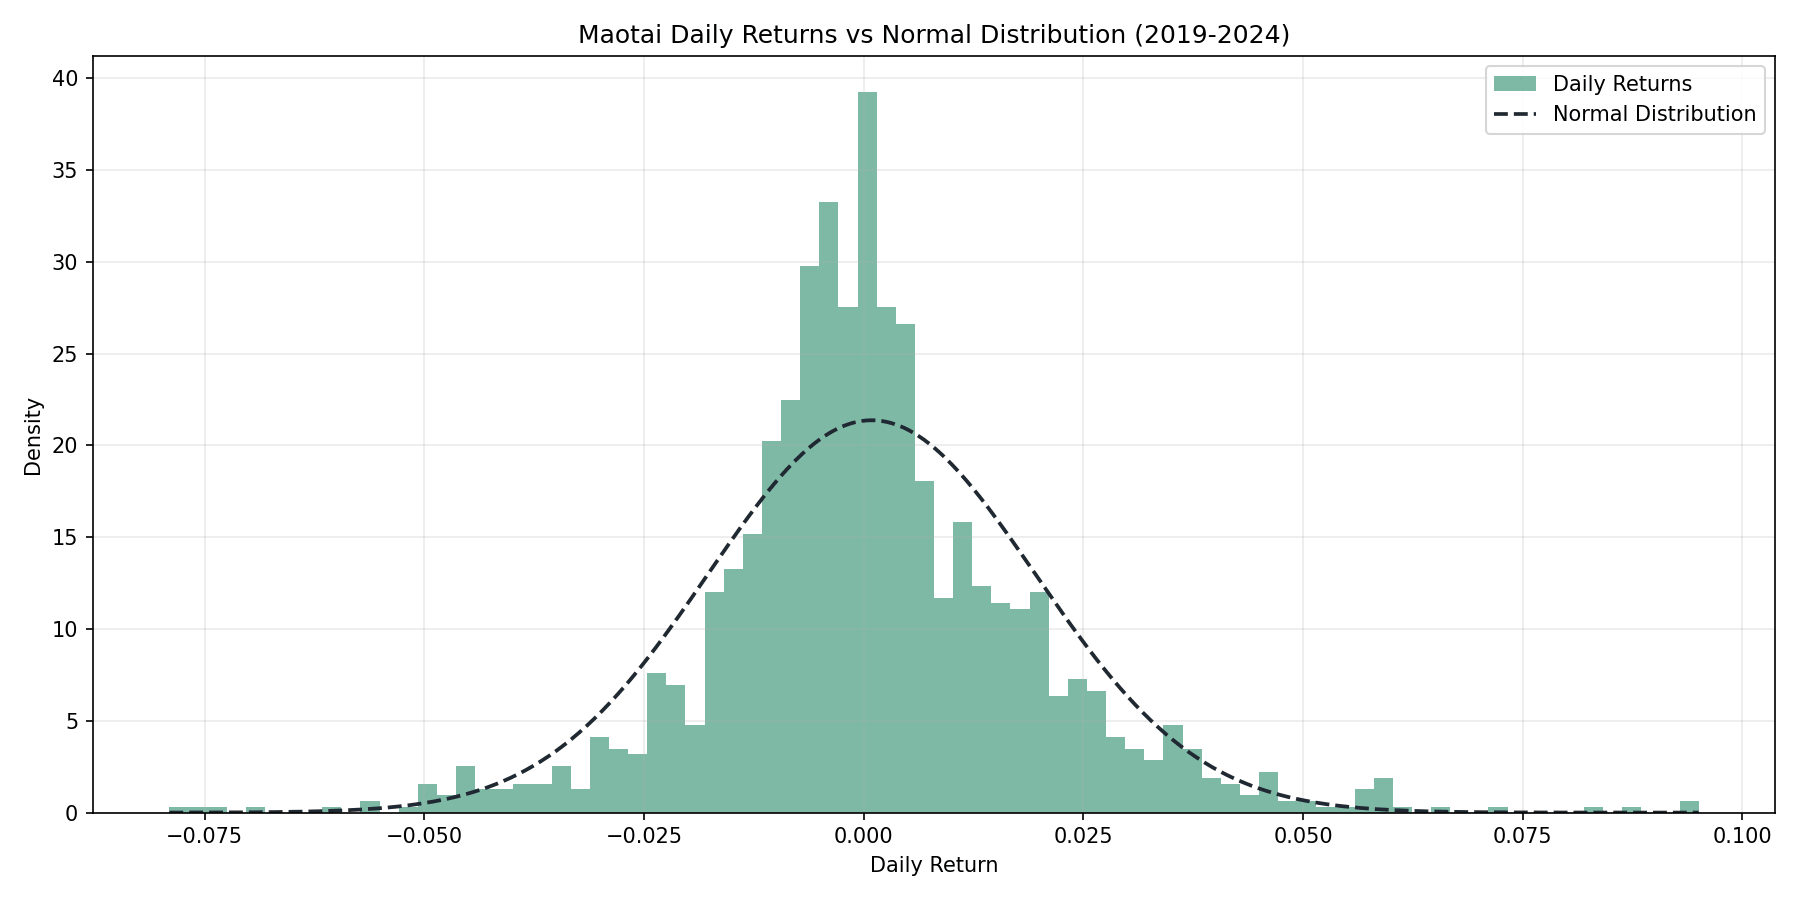
图形中间高出正态曲线一截,两侧极端值也明显更多。这就是为什么风险管理不能只看标准差,最大回撤这类"尾部指标"必须单独计算。
平稳性:时间序列的地基
平稳序列的统计性质(均值、方差)不随时间变化;非平稳序列的均值在漂移,"平均值"这个概念对它意义有限。
用 ADF 检验(Augmented Dickey-Fuller)判断平稳性,零假设是"序列非平稳":
实例
# 分别检验价格序列与收益率序列
for name, series in [("价格", close), ("收益率", ret)]:
stat, pvalue, *_ = adfuller(series.dropna())
verdict = "平稳" if pvalue < 0.05 else "非平稳"
print(f"{name}序列: ADF 统计量 {stat:.4f}, p 值 {pvalue:.4f} -> {verdict}")
输出结果如下所示:
价格序列: ADF 统计量 -2.6077, p 值 0.0914 -> 非平稳
收益率序列: ADF 统计量 -25.5904, p 值 0.00e+00 -> 平稳
结论是金融时间序列的经典事实:价格非平稳,收益率平稳。
这解释了为什么所有模型都建立在收益率而不是价格上:对非平稳序列做回归和均值估计会得到大量虚假结果。
直觉理解:茅台价格从 1000 元涨到 1500 元,"均值 1250 元"没有任何预测意义;但"日收益率平均 0.09%、波动 1.87%"则是相对稳定的特征。建模要建立在稳定的特征上。
相关性的局限
第 7 篇用相关性热力图比较过白酒三兄弟,皮尔逊相关系数高就代表可以做交易了吗?不够。
相关性有两个致命局限:
一是相关性只衡量"同涨同跌的幅度",不保证两者的差稳定——两只股票同涨同跌,但差距可以越拉越远,永远不回归。
二是相关性会漂移,牛市里高度相关的资产,危机中可能瞬间脱钩。
要判断"两者差距会不会回归",需要比相关性更强的工具——协整。
协整:配对交易的地基
协整(Cointegration)回答的问题是:两个各自非平稳的序列,它们的线性组合(价差)是否平稳。
如果价差平稳,就意味着价差涨高了会跌回来、跌深了会涨回去——这正是配对交易赚钱的来源:卖高买低,等价差回归。
statsmodels 的 coint 函数直接做协整检验,零假设是"不存在协整关系"。对同行业候选配对做一轮扫描:
实例
import yfinance as yf
candidates = [
("五粮液", "泸州老窖", "000858.SZ", "000568.SZ"),
("工商银行", "招商银行", "601398.SS", "600036.SS"),
("美的集团", "格力电器", "000333.SZ", "000651.SZ"),
("贵州茅台", "五粮液", "600519.SS", "000858.SZ"),
]
for n1, n2, c1, c2 in candidates:
px = yf.download([c1, c2], start="2022-01-01", end="2024-12-31",
progress=False, multi_level_index=False)["Close"]
x, y = px[c1].dropna(), px[c2].dropna()
idx = x.index.intersection(y.index)
t, p, _ = coint(x.loc[idx], y.loc[idx])
verdict = "通过" if p < 0.05 else "未通过"
print(f"{n1} vs {n2}: p = {p:.4f} {verdict}")
输出结果如下所示:
五粮液 vs 泸州老窖: p = 0.2166 未通过
工商银行 vs 招商银行: p = 1.0000 未通过
美的集团 vs 格力电器: p = 0.0617 未通过
贵州茅台 vs 五粮液: p = 0.2300 未通过
用同样的方法扫描石油石化(中国石油 vs 中国石化 p=0.4855)、保险(中国平安 vs 中国人寿 p=0.1590)、电信运营商(中国移动 vs 中国电信 p=0.3953)等行业,七对候选无一通过 5% 显著性检验。
这个"全军覆没"的结果非常有教育意义:
| 常见误解 | 事实 |
|---|---|
| 同行业股票就能做配对 | 七对同行业候选无一通过检验 |
| 相关性高等于协整 | 这些股票对相关性都在 0.7 以上,依然不协整 |
| 协整关系一劳永逸 | 即使历史上通过,结构变化也可能让它失效 |
七对中美的集团与格力电器最接近(p=0.0617),作为下一篇配对交易的教学演示案例——但它未达 5% 显著水平,这一点会贯穿下一篇的结论。
对冲比率与价差
协整检验之外,配对交易还需要估计对冲比率:一股美的对应多少股格力。最简单的方法是线性回归斜率:
实例
import yfinance as yf
px = yf.download(["000333.SZ", "000651.SZ"], start="2022-01-01",
end="2024-12-31", progress=False,
multi_level_index=False)["Close"]
# 只用 2022 年数据估计,避免用到未来的信息
a = px["000333.SZ"].loc["2022"] # 美的
b = px["000651.SZ"].loc["2022"] # 格力
beta = np.polyfit(b, a, 1)[0]
print(f"对冲比率 beta = {beta:.4f}")
# 价差 = 美的价格 - beta x 格力价格
spread = px["000333.SZ"] - beta * px["000651.SZ"]
print("价差末 3 日:")
print(spread.tail(3).round(2).to_string())
输出结果如下所示:
对冲比率 beta = 2.8141
价差末 3 日:
Date
2024-12-26     9.06
2024-12-27     9.05
2024-12-30     8.29
含义是:做多 1 股美的的同时做空 2.81 股格力,这个组合的价值就是价差。下一篇会围绕这个价差构造完整的交易规则。


点我分享笔记