Python 投资组合理论
"不要把鸡蛋放在同一个篮子里"人人会说,但篮子怎么选、鸡蛋怎么分,是有严谨数学的。
本篇用三只真实的 A 股(贵州茅台、工商银行、宁德时代),完整走一遍马科维茨组合理论:随机组合散点、最大夏普组合、CAPM Beta 与风险平价。
分散化的数学本质
先看三只股票 2019-2024 的年化收益与波动(由日收益率计算):
实例
import pandas as pd
import numpy as np
# 三只不同行业的 A 股:消费、银行、新能源
symbols = ["600519.SS", "601398.SS", "300750.SZ"]
names = ["贵州茅台", "工商银行", "宁德时代"]
prices = yf.download(symbols, start="2019-01-01", end="2024-12-31",
progress=False, multi_level_index=False)["Close"]
daily_ret = prices.pct_change().dropna()
# 年化收益(几何复利)与年化波动
mu_ann = (1 + daily_ret).prod() ** (252 / len(daily_ret)) - 1
vol_ann = daily_ret.std() * np.sqrt(252)
print(pd.DataFrame({"年化收益": mu_ann, "年化波动": vol_ann},
index=names).round(4).to_string())
输出结果如下所示:
          年化收益    年化波动
贵州茅台   0.2012   0.2964
工商银行   0.1127   0.1605
宁德时代   0.3944   0.4611
三只股票风险收益特征迥异:宁德时代收益最高波动也最大,工商银行收益最低但最稳。
分散化的魔法藏在协方差矩阵里:组合的波动不只取决于各资产的波动,更取决于它们的相关性。
实例
cov_ann = daily_ret.cov() * 252
print(cov_ann.round(4).to_string())
输出结果如下所示:
          600519.SS  601398.SS  300750.SZ
600519.SS     0.0878     0.0094     0.0498
601398.SS     0.0094     0.0258     0.0013
300750.SZ     0.0498     0.0013     0.2126
注意非对角元素(协方差)远小于对角元素(方差)——三只股票两两相关性不高。组合波动公式中这些"交叉项"会被部分抵消,这就是分散化降低风险的来源。
有效前沿:5000 组随机组合
给定一组权重 w,组合的年化收益与波动可以直接算出。用 5000 组随机权重扫描"风险-收益"平面:
实例
weights = rng.dirichlet(np.ones(3), 5000) # 5000 组随机权重,每组和为 1
# 组合收益:权重点乘各资产收益
port_ret = weights @ mu_ann.values
# 组合波动:w^T x 协方差 x w 的平方根
port_vol = np.sqrt(np.einsum("ij,jk,ik->i", weights, cov_ann.values, weights))
sharpe = (port_ret - 0.03) / port_vol # 无风险利率取 3%
best = sharpe.argmax()
print(f"随机组合中最大夏普: {sharpe[best]:.3f}")
print("最大夏普组合权重:")
print(pd.Series(weights[best], index=names).round(4).to_string())
输出结果如下所示:
随机组合中最大夏普: 0.960
最大夏普组合权重:
贵州茅台    0.1539
工商银行    0.5546
宁德时代    0.2915
把 5000 个点画出来,就是教科书上的"子弹头"图形:
实例
fig, ax = plt.subplots(figsize=(12, 7))
sc = ax.scatter(port_vol, port_ret, c=sharpe, cmap="viridis",
s=6, alpha=0.6)
plt.colorbar(sc, ax=ax, label="Sharpe Ratio")
ax.scatter(port_vol[best], port_ret[best], marker="*", s=420,
color="#c0563f", zorder=3, label="Max Sharpe Portfolio")
for i, name in enumerate(names):
ax.scatter(vol_ann.iloc[i], mu_ann.iloc[i], marker="o",
s=90, color="#1f2933", zorder=3)
ax.annotate(name, (vol_ann.iloc[i], mu_ann.iloc[i]),
xytext=(8, 6), textcoords="offset points", fontsize=11)
ax.set_title("5000 Random Portfolios: Risk vs Return (2019-2024)")
ax.set_xlabel("Annualized Volatility")
ax.set_ylabel("Annualized Return")
ax.legend()
ax.grid(alpha=0.25)
plt.show()
执行以上代码,输出的图表如下:
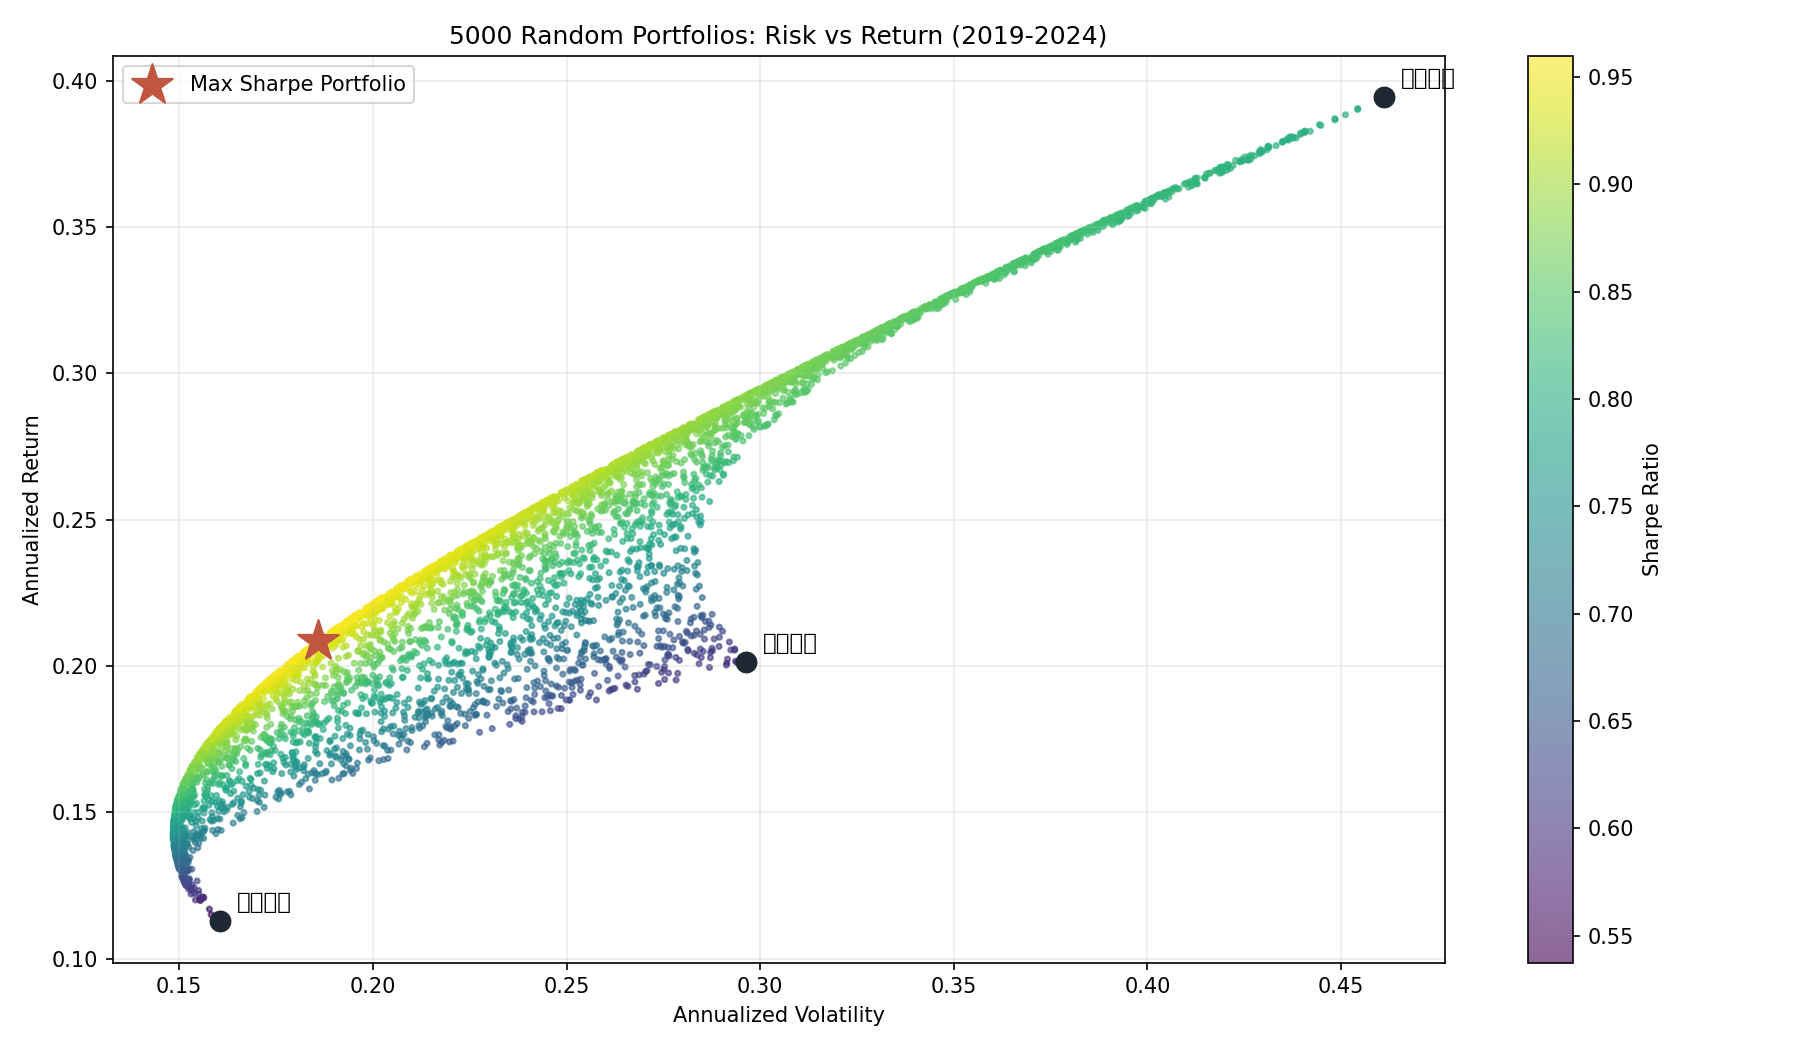
图形揭示三个重要事实:
| 观察 | 含义 |
|---|---|
| 所有散点都在单个资产左侧 | 组合可以做到比任何成分股波动更低——分散化有效 |
| 散点构成"子弹头"左边界 | 这条边界就是有效前沿,同等风险下收益最高的组合集合 |
| 最大夏普组合夏普 0.960 | 高于任一单资产(茅台 0.578、工行 0.515、宁德 0.790) |
最大夏普组合只持 15% 茅台、55% 工行——收益最高的宁德时代只占 29%。因为工行与另外两只相关性极低(协方差 0.0094 与 0.0013),它是最好的"分散器"。
提醒:随机搜索只是演示原理,工程上用 scipy.optimize 最小化负夏普求解。此外历史协方差不稳定,有效前沿会随时间移动,别把它当永久的地图。
CAPM:给股票的"市场敏感度"打分
资本资产定价模型(CAPM)把资产收益拆成两部分:跟随市场的 Beta 与超额的 Alpha。
Beta 的估计就是个股收益对市场收益的回归斜率。用跟踪沪深300 的 ETF(510300.SS)做市场代理:
实例
bench = yf.download("510300.SS", start="2019-01-01", end="2024-12-31",
progress=False, multi_level_index=False)["Close"]
mkt_ret = bench.pct_change().dropna()
for sym, name in zip(symbols, names):
r = daily_ret[sym]
common = r.index.intersection(mkt_ret.index)
beta = np.polyfit(mkt_ret.loc[common], r.loc[common], 1)[0]
print(f"{name}: Beta = {beta:.3f}")
输出结果如下所示:
贵州茅台: Beta = 1.008
工商银行: Beta = 0.302
宁德时代: Beta = 1.301
| Beta 区间 | 含义 |
|---|---|
| Beta = 1 | 与市场同步波动 |
| Beta > 1 | 市场涨 10% 它涨更多,进攻型 |
| Beta < 1 | 波动小于市场,防御型 |
| Beta < 0 | 与市场反向,罕见 |
工行 Beta 只有 0.302——大盘跌 10% 它平均只跌 3%,正是它成为优秀分散器的原因,与有效前沿的发现互相印证。
风险平价:让每种资产贡献相同的风险
等权组合看似公平,实际上高波动资产贡献了大部分风险。风险平价(Risk Parity)按波动率倒数分配权重,让每类资产的风险贡献接近:
实例
inv_vol = 1 / vol_ann
rp_weights = inv_vol / inv_vol.sum()
print(pd.Series(rp_weights.values, index=names).round(4).to_string())
输出结果如下所示:
贵州茅台    0.2866
工商银行    0.5292
宁德时代    0.1842
宁德时代波动最大,权重被压到最低的 18%;工行最稳,占 53%。
| 方案 | 权重逻辑 | 适合谁 |
|---|---|---|
| 等权 | 各 1/3 | 最简单,但风险被高波动资产主导 |
| 市值加权 | 按市值分配 | 指数基金的做法 |
| 反波动率 | 波动倒数 | 追求均衡风险贡献 |
| 最大夏普 | 优化求解 | 收益导向,但对参数敏感 |
注意:以上全部基于 2019-2024 历史数据。收益与相关性都会漂移,历史最优组合不等于未来最优组合——这个主题在参数优化一篇会系统性展开。


点我分享笔记