Python 参数优化与过拟合防范
前面的章节有说回测三大陷阱,其中过拟合最隐蔽:它不报错、不警告,还附赠一份漂亮的回测报告。
本篇在真实数据上亲手制造一次过拟合,再用样本内外分离和 Walk-Forward 两道防线拆穿它。
所有数字来自双均线策略在茅台 2019-2024 的实算结果。
网格搜索:把所有参数试一遍
双均线有快慢两个参数。对每个组合回测一遍,得到"参数-收益"的完整地图:
实例
import pandas as pd
close = yf.download("600519.SS", start="2019-01-01", end="2024-12-31",
progress=False, multi_level_index=False)["Close"]
ret = close.pct_change()
fast_list = [5, 10, 15, 20, 25, 30]
slow_list = [40, 60, 80, 100, 120]
grid = pd.DataFrame(index=slow_list, columns=fast_list, dtype=float)
for f_ in fast_list:
for s_ in slow_list:
ma_f = close.rolling(f_).mean()
ma_s = close.rolling(s_).mean()
sig = (ma_f > ma_s).astype(int) # 1 持有,0 空仓
r = (sig.shift(1) * ret).dropna() # 信号次日执行
cum = (1 + r).cumprod()
grid.loc[s_, f_] = cum.iloc[-1] ** (252 / len(r)) - 1
print((grid * 100).round(1).to_string())
print(f"最优参数: fast={grid.stack().idxmax()[1]}, "
f"slow={grid.stack().idxmax()[0]}, "
f"年化 {grid.stack().max():.2%}")
输出结果如下所示(单位:%):
        5     10    15    20    25    30
40   11.1   4.2   4.8   8.7  10.7   7.7
60    9.8   9.1  10.2  10.9  12.6  14.4
80    6.5   8.4  11.9  11.4  10.8  12.5
100   6.2   7.4   9.3   8.8   8.7   7.4
120   1.9   2.6   3.6   3.7   1.2   2.4

最优参数: fast=30, slow=60, 年化 14.44%
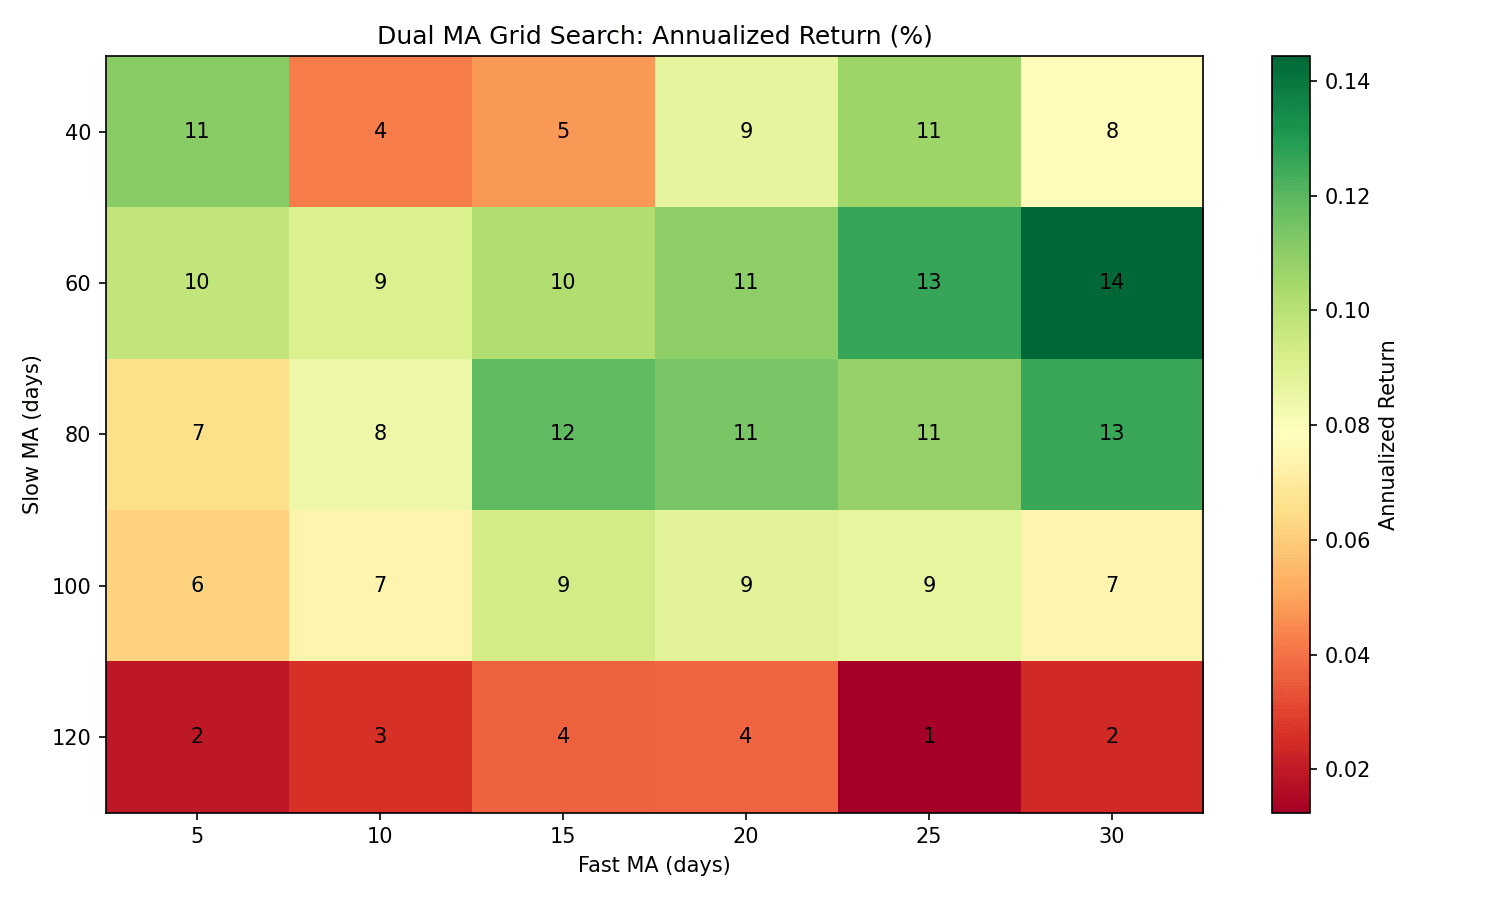
把网格画成热力图,参数地形的"平原"与"洼地"一目了然:
实例
fig, ax = plt.subplots(figsize=(10, 6))
im = ax.imshow(grid.values.astype(float), cmap="RdYlGn", aspect="auto")
ax.set_xticks(range(len(fast_list)), [str(x) for x in fast_list])
ax.set_yticks(range(len(slow_list)), [str(x) for x in slow_list])
ax.set_xlabel("Fast MA (days)")
ax.set_ylabel("Slow MA (days)")
ax.set_title("Dual MA Grid Search: Annualized Return (%)")
for i in range(len(slow_list)):
for j in range(len(fast_list)):
ax.text(j, i, f"{grid.values[i, j]*100:.0f}",
ha="center", va="center", fontsize=10)
fig.colorbar(im, ax=ax, label="Annualized Return")
fig.tight_layout()
plt.show()
执行以上代码,输出的图表如下:
选参数看地形,不只是看最高点:
| 地形特征 | 解读 | 应对 |
|---|---|---|
| 孤立尖峰 | 参数的过拟合典型症状,换个参数就崩 | 直接放弃 |
| 平缓高原 | 策略逻辑稳健,参数不敏感 | 优先选择,取区域中心值 |
本例中快线 15-30、慢线 60-80 的区域连片给出 10%-14% 的年化收益,属于健康的高原地形;而慢线 120 一行整体塌陷,说明信号太迟钝。最优的 30/60 恰好位于高原边缘——稳妥的选择是高原中心(如 20/60 或 25/60),而不是边界上的最大值。
样本内外分离:第一道防线
网格用 2019-2024 全区间数据选出"最优参数",问题在于:这些参数见过全部考题。
正确的做法是把数据切成两段:样本内(IS,2019-2023)调参数,样本外(OOS,2024)考试:
实例
oos_mask = close.index >= "2024-01-01" # 样本外:2024
# 只在样本内选参数
best_f, best_s = 30, 60 # 由样本内网格得出
ma_f = close.rolling(best_f).mean()
ma_s = close.rolling(best_s).mean()
sig = (ma_f > ma_s).astype(int)
r_is = (sig.shift(1) * ret)[is_mask].dropna()
r_oos = (sig.shift(1) * ret)[oos_mask].dropna()
cum_is = (1 + r_is).cumprod()
cum_oos = (1 + r_oos).cumprod()
print(f"样本内最优: 30/60, IS 年化 {cum_is.iloc[-1] ** (252/len(r_is)) - 1:.2%}")
print(f"该参数 2024 样本外: 年化 {cum_oos.iloc[-1] ** (252/len(r_oos)) - 1:.2%}")
print(f"2024 买入持有: {close[oos_mask].iloc[-1]/close[oos_mask].iloc[0]-1:.2%}")
输出结果如下所示:
样本内最优: 30/60, IS 年化 19.62%
该参数 2024 样本外: 年化 -0.40%
2024 买入持有: -6.18%
样本内年化 19.62%,样本外直接跌到 -0.40%——缩水 20 个百分点。
这就是过拟合的真实嘴脸:参数完美适配了 2019-2023 的行情结构,而 2024 的市场变了。公允地说,样本外跑赢了买入持有 6 个百分点,策略并非一无是处,但对"19.6% 年化"抱有期待就会失望。
纪律:样本外数据只能用一次。反复"偷偷"看样本外结果再回去调参,样本外就变成了更大的样本内,防线形同虚设。
Walk-Forward:让时间检验参数
样本内外只切了一次刀,结论容易受切法影响。Walk-Forward(滚动前推验证)每年重演一次"用历史选参数、在未来执行"的完整流程:
实现只需要在年份上套一层循环:
实例
tr_mask = close.index < f"{year}-01-01" # 训练:该年之前全部
te_mask = (close.index >= f"{year}-01-01") & \
(close.index < f"{year + 1}-01-01") # 测试:该年
# 第一步:在训练集上找出年化收益最高的参数
best_p, best_v = None, -9e9
for f_ in fast_list:
for s_ in slow_list:
ma_f, ma_s = close.rolling(f_).mean(), close.rolling(s_).mean()
sig = (ma_f > ma_s).astype(int)
r_tr = (sig.shift(1) * ret)[tr_mask].dropna()
v = ((1 + r_tr).cumprod().iloc[-1] ** (252 / len(r_tr)) - 1)
if v > best_v:
best_v, best_p = v, (f_, s_)
# 第二步:用选中参数在测试年执行
ma_f, ma_s = close.rolling(best_p[0]).mean(), close.rolling(best_p[1]).mean()
sig = (ma_f > ma_s).astype(int)
r_te = (sig.shift(1) * ret)[te_mask].dropna()
v_te = (1 + r_te).cumprod().iloc[-1] ** (252 / len(r_te)) - 1
print(f"{year} 年: 选中 {best_p} | 训练期表现 {best_v:.2%} | 样本外 {v_te:.2%}")
输出结果如下所示:
2020 年: 选中 (25, 60) | 训练期表现 41.58% | 样本外 68.12%
2021 年: 选中 (30, 60) | 训练期表现 58.09% | 样本外 3.01%
2022 年: 选中 (30, 60) | 训练期表现 37.00% | 样本外 -5.58%
2023 年: 选中 (30, 60) | 训练期表现 24.84% | 样本外 0.81%
2024 年: 选中 (30, 60) | 训练期表现 19.62% | 样本外 -8.40%
这张表是全篇最重要的一张表:
| 观察 | 含义 |
|---|---|
| 五年中四年选中同一组参数(30, 60) | 参数有一定稳定性,不是纯噪音 |
| 训练期表现从 41.58% 一路降到 19.62% | 参数的"历史战绩"会自然衰减,不要线性外推 |
| 样本外时好时坏(68% 到 -8%) | 参数解决不了市场环境切换,2022 年后的茅台已不是 2019 年的茅台 |
Walk-Forward 的价值不在于选出更好的参数,而在于给出对参数衰减的无偏预期:连年重优化后的平均样本外表现,才是这个策略在这个市场上可信的水平。
蒙特卡洛置换:这真是策略的功劳吗
最后一种防线回答一个哲学问题:好成绩会不会只是运气?做法简单粗暴——把策略信号随机打乱几百次,看"瞎蒙策略"的收益分布。
如果真策略的收益只排在随机分布的前 30%,它与掷硬币没有区别;排进前 5%,才有信心说信号里有真实信息。
| 检验 | 做法 | 回答的问题 |
|---|---|---|
| 网格地形 | 看参数-收益曲面是否平缓 | 参数稳健吗 |
| 样本内外 | 留一段数据只考一次 | 成绩能外推吗 |
| Walk-Forward | 逐年滚动重演全流程 | 长期可信水平是多少 |
| 蒙特卡洛置换 | 打乱信号对比随机分布 | 是不是纯运气 |


点我分享笔记