Python 量化数据清洗与处理
原始金融数据几乎是"脏"的:停牌造成缺失、分红造成跳空、极端行情造成离群点。
垃圾进、垃圾出——输入数据的质量直接决定回测结论的可信度。
本篇用真实的茅台数据演示四类最常用的清洗操作。
金融数据的常见问题
拿到一份数据后,通常要检查并处理以下四类问题:
| 问题 | 来源 | 处理方式 |
|---|---|---|
| 缺失值 | 停牌、上市初期、数据源漏传 | 前向填充或剔除 |
| 异常值 | 真实极端行情、数据错误 | 先甄别真假,再决定处理 |
| 价格跳空 | 分红送股除权 | 改用复权价格 |
| 频率不齐 | 不同市场交易日历不同 | 重采样与对齐 |
上一篇文章已经讲过价格跳空的成因与复权处理,本篇聚焦其余三类。
缺失值处理
先人为制造缺失,再演示标准处理流程。金融时间序列首选前向填充:停牌期间没有新价格,用最近一个有效价格代替最合理。
实例
import numpy as np
# 下载茅台复权收盘价(2019-2024)
close = yf.download("600519.SS", start="2019-01-01", end="2024-12-31",
progress=False, multi_level_index=False)["Close"]
# 人为挖掉 3 天数据,模拟停牌缺失
dirty = close.copy()
dirty.iloc[10:13] = np.nan
print("挖空后缺失数:", int(dirty.isna().sum()))
# 前向填充:用最近一个有效价格填充
filled = dirty.ffill()
print("ffill 填充后缺失数:", int(filled.isna().sum()))
print(filled.iloc[9:14].round(2).to_string())
输出结果如下所示:
挖空后缺失数: 3
ffill 填充后缺失数: 0
Date
2019-01-15    550.41
2019-01-16    550.41
2019-01-17    550.41
2019-01-18    550.41
2019-01-21    572.93
三行缺失都被填充为 1 月 15 日的收盘价 550.41,直到 1 月 21 日出现新价格。
注意:不要用后向填充 bfill 处理回测数据——它把"未来的价格"填进了"过去的日期",属于典型的未来函数。同理,用均值、中位数填充时间序列也会引入前晚于时点该知道的信息之外的不自然结构。
异常值检测
收益率序列中最常用的异常值判据是 3σ 原则:偏离均值超过 3 倍标准差的点视为异常。
但对金融数据要格外小心:超过 3σ 的点未必是错误,可能只是真实的极端行情。
实例
ret = close.pct_change().dropna()
# 3σ 原则筛出异常点
mu, sd = ret.mean(), ret.std()
outliers = ret[(ret - mu).abs() > 3 * sd]
print(f"日收益率均值 {mu:.4%} 标准差 {sd:.4%}")
print(f"3σ 异常点 {len(outliers)} 个:")
print(outliers.round(4).to_string())
输出结果如下所示:
日收益率均值 0.0901% 标准差 1.8671%
3σ 异常点 22 个:
Date
2020-07-16   -0.0790
2021-09-27    0.0950
2022-10-24   -0.0756
2022-11-01    0.0830
2024-09-24    0.0880
2024-09-26    0.0929
2024-09-30    0.0729
2024-10-09   -0.0742
...(共 22 个)
抽查几个日期就能确认:2020 年 7 月 16 日是白酒板块大跌,2024 年 9 月末是政策驱动的全面暴涨——这些都是真实行情,绝不能删。
正确的工作流是:先用 3σ 或四分位距(IQR)把离群点捞出来,逐一核对是不是数据错误(比如小数点错位、价格为 0、复权漏调),只有确认是错误的才修正。
易错点:新手常把涨跌停日的 ±10% 当异常值删掉,这等于删掉了 A 股最真实的制度特征。异常值检测的目的是"发现",不是"删除"。
频率转换
研究周线、月线级别策略时,需要把日线重采样为更低频率。pandas 的 resample 一行搞定:
实例
weekly = close.resample("W-FRI").last()
# 月线:取每月最后一个交易日
monthly = close.resample("ME").last()
print("周线末 3 行:")
print(weekly.tail(3).round(2).to_string())
print("月线末 3 行:")
print(monthly.tail(3).round(2).to_string())
输出结果如下所示:
周线末 3 行:
Date
2024-12-20    1433.74
2024-12-27    1440.31
2025-01-03    1436.57
Freq: W-FRI
月线末 3 行:
Date
2024-10-31    1417.04
2024-11-30    1415.14
2024-12-31    1436.57
Freq: ME
重采样时聚合规则要看字段:价格用 last(或 first),成交量用 sum,最高价用 max,最低价用 min。
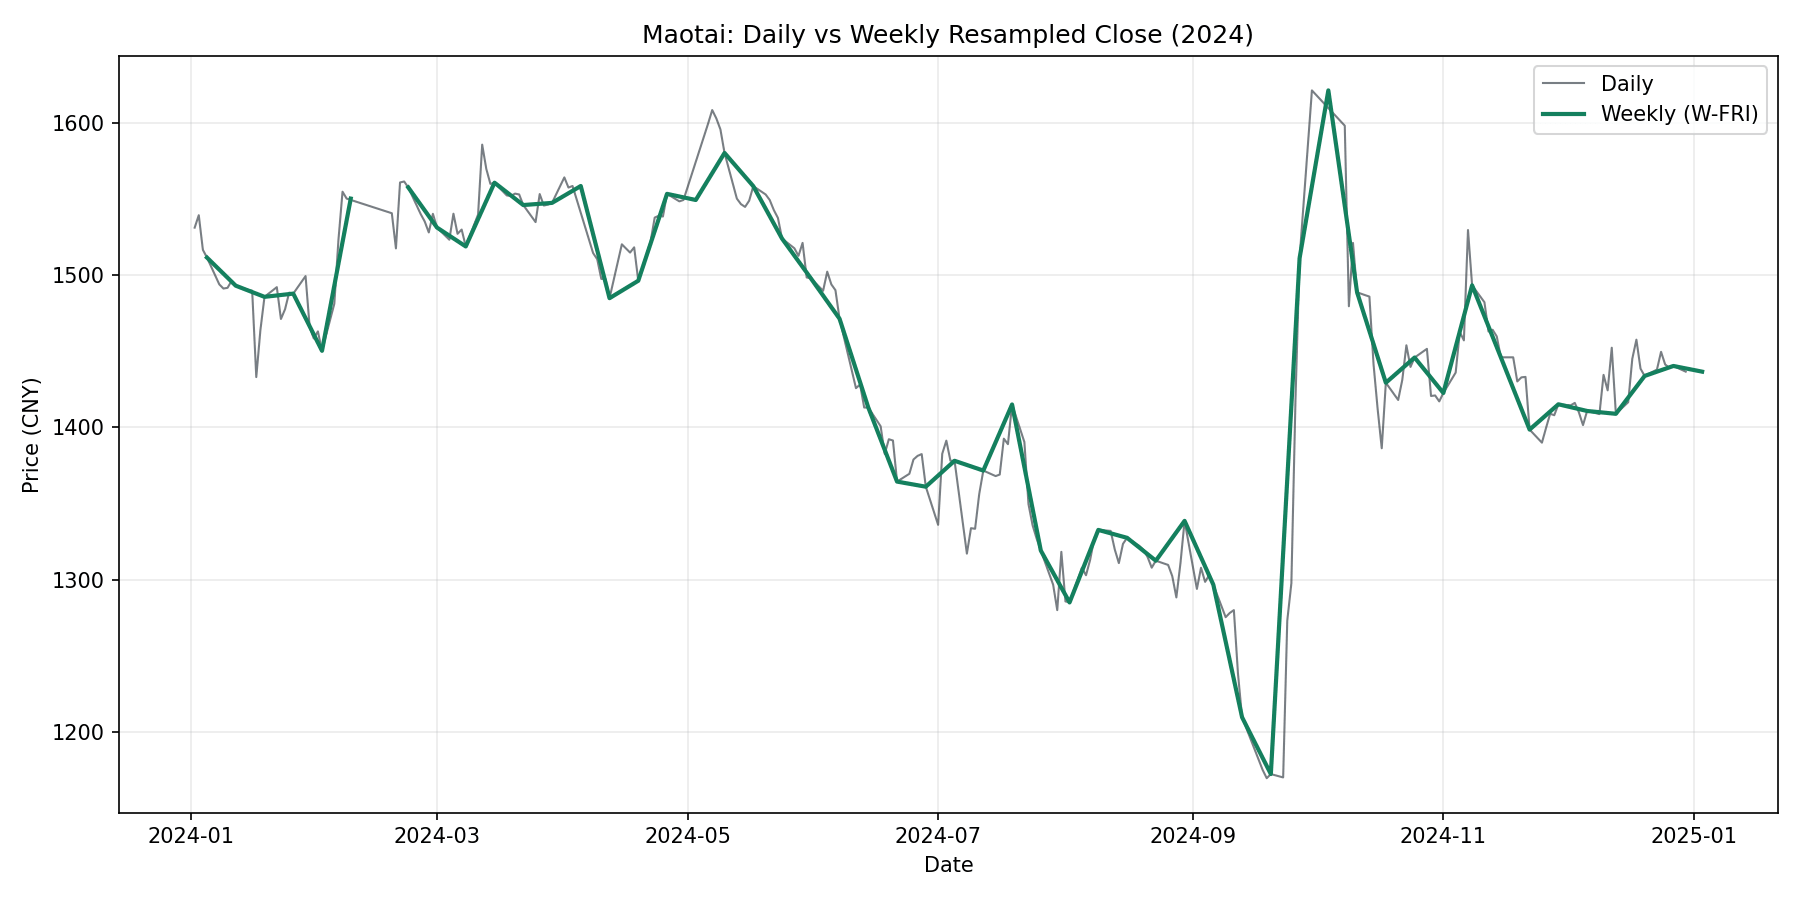
日线与周线画在一起,可以看出周线是日线的"骨架":
实例
plt.figure(figsize=(12, 6))
plt.plot(close.loc["2024-01-01":], label="Daily",
color="#1f2933", linewidth=1.0, alpha=0.6)
plt.plot(weekly.loc["2024-01-01":], label="Weekly (W-FRI)",
color="#14805e", linewidth=2)
plt.title("Maotai: Daily vs Weekly Resampled Close (2024)")
plt.xlabel("Date")
plt.ylabel("Price (CNY)")
plt.legend()
plt.grid(alpha=0.25)
plt.show()
执行以上代码,输出的图表如下:
提示:反向操作(低频转高频)只能通过插值"猜"出来,不产生真实信息,回测中应避免用插值出的高频数据。
多只股票的日期对齐
不同股票的交易日历可能不一致(停牌、上市时间不同),直接相减会错位。pandas 在算术运算时会自动按索引对齐并补 NaN,处理方法是先对齐再清洗:
实例
# 下载两只股票的复权收盘价
prices = yf.download(["600519.SS", "000858.SZ"], start="2023-01-01",
end="2024-12-31", progress=False,
multi_level_index=False)["Close"]
# 对齐后统一前向填充,保证每一天都有双方的价格
prices = prices.ffill().dropna()
print("对齐后行数:", len(prices))
# 对齐之后才能安全地计算比值、协整、价差等
ratio = prices["600519.SS"] / prices["000858.SZ"]
print(ratio.tail(3).round(4).to_string())
输出结果如下所示:
对齐后行数: 483
Date
2024-12-26    11.1941
2024-12-27    11.2004
2024-12-30    11.2749
记住这个顺序:先对齐,再填充,再计算。直接对未对齐的数据做运算,NaN 会悄悄吞掉大量样本。


点我分享笔记